ChatGPT SEO: So wird Ihre Website in KI-Antworten zur Quelle

In Kürze

ChatGPT SEO auf einen Blick

  • Zwei Absichten: Der Begriff meint die Sichtbarkeit in ChatGPT-Antworten und den Einsatz von ChatGPT als Werkzeug. Der größere Hebel liegt bei der Sichtbarkeit.
  • Entscheidender Crawler: Über die Aufnahme in die ChatGPT-Suche entscheidet OAI-SearchBot, nicht GPTBot. Beide lassen sich in der robots.txt getrennt steuern.
  • Zusammenhang mit Google: Organische Sichtbarkeit und KI-Zitierungen korrelieren mit 0,66 (SISTRIX und LEAP, 2026). Auf das sichtbarste Fünftel der untersuchten Shops entfallen 72,4 Prozent aller Nennungen.
  • Messbarkeit: Bei identischen Fragen überschneiden sich die zitierten Quellen von Tag zu Tag nur zu 34 bis 42 Prozent. Einzelne Screenshots belegen nichts.

Stand: 24. September 2026

ChatGPT SEO umfasst alle Maßnahmen, mit denen eine Website in den Antworten von ChatGPT als Quelle genannt wird: freier Zugang für den Suchcrawler OAI-SearchBot, Inhalte mit prüfbaren Fakten und direkten Antworten sowie Erwähnungen auf anderen Websites. Daneben bezeichnet der Begriff den Einsatz von ChatGPT als Werkzeug für die eigene Suchmaschinenoptimierung.
Was ChatGPT SEO bedeutet und was der Begriff verschweigt

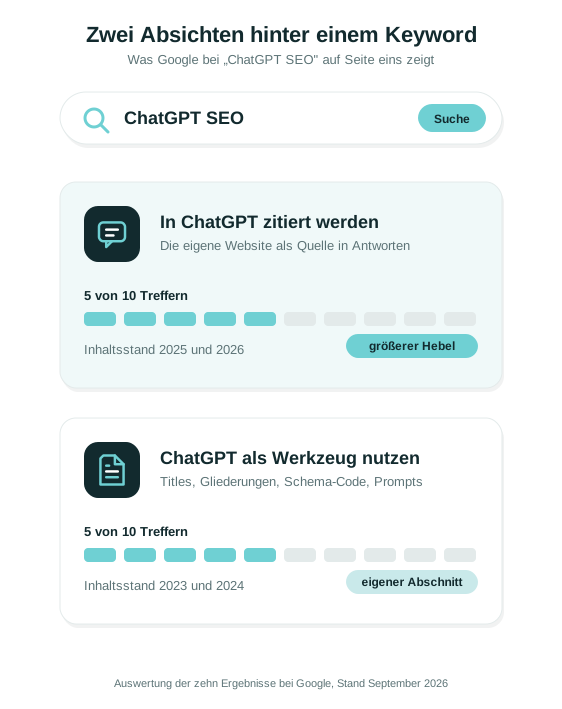
Hinter dem Suchbegriff stecken zwei verschiedene Absichten, und die Ergebnisseite bei Google bildet beide ab. Von den zehn Seiten, die dort vorn stehen, behandeln fünf die Sichtbarkeit der eigenen Website in ChatGPT-Antworten und fünf den Einsatz von ChatGPT für Recherche und Texte. Alle Seiten zur Sichtbarkeit stammen aus den Jahren 2025 und 2026, die Seiten zum Werkzeug überwiegend aus 2023 und 2024. Die Gewichtung hat sich verschoben, seit ChatGPT eine eigene Suchfunktion mit Quellenangaben besitzt und damit selbst zum Wettbewerber um Sichtbarkeit geworden ist.

Suchleiste und zwei Karten für die beiden Suchabsichten hinter ChatGPT SEO

Wie groß ist der Kanal ChatGPT für deutsche Websites?

Gemessen an Besuchen bleibt ChatGPT ein kleiner Kanal, gemessen an Reichweite und Rechtslage ein großer. Auf der einen Seite stehen Traffic-Anteile im Promillebereich, die sich in Analytics kaum vom Rauschen abheben. Dem gegenüber steht eine Suchfunktion mit über 159 Millionen monatlichen Nutzern in der EU, die die Europäische Kommission seit August 2026 wie Google und Bing behandelt.

Für die Budgetentscheidung zählt weniger die Besucherzahl als die Frage, ob die eigene Zielgruppe vor einem Kauf ChatGPT befragt. Erklärungsbedürftige Leistungen mit hohem Auftragswert rechnen sich schon mit wenigen Besuchen aus diesem Kanal, Massenware mit Preisfokus dagegen kaum.

Wie viel Traffic aus ChatGPT bei Websites ankommt

Im Jahr 2026 stammen 0,32 Prozent aller Website-Besuche aus KI-Systemen, nach 0,24 Prozent im Jahr 2025 und 0,02 Prozent im Jahr 2024. SE Ranking hat diese Werte über 101.574 Websites in 250 Ländern erhoben, gemessen von Januar 2025 bis April 2026. Innerhalb des KI-Anteils entfallen 74,78 Prozent auf ChatGPT, gefolgt von Gemini mit 11,56 Prozent und Perplexity mit 7,23 Prozent. Zum Vergleich liefert die organische Suche im selben Datensatz 42,75 Prozent aller Besuche, also 134-mal so viele wie sämtliche KI-Systeme zusammen.

Übersetzt auf eine Website mit 10.000 Besuchen im Monat kommen 32 Besuche aus KI-Systemen, davon 24 aus ChatGPT. Der Kanal rechtfertigt keine eigene Abteilung, wächst aber schneller als jeder andere. Anfang 2025 lag das Verhältnis zwischen organischer Suche und KI-Systemen laut derselben Erhebung noch bei rund 300 zu 1.

Warum die EU ChatGPT seit August 2026 als Suchmaschine einstuft

Am 31. August 2026 hat die Europäische Kommission ChatGPT als Very Large Online Search Engine nach dem Digital Services Act eingestuft, der höchsten Aufsichtsstufe des Gesetzes und derselben Kategorie wie Google und Bing. Grundlage ist die Angabe von OpenAI, dass die ChatGPT-Suche im Halbjahr bis zum 31. März 2026 durchschnittlich 159,1 Millionen monatlich aktive Nutzer in der EU hatte. Diese Einstufung setzt eine Schwelle von 45 Millionen voraus. Vier Monate nach der Zustellung gelten für OpenAI zusätzliche Pflichten: jährliche Risikoprüfungen, unabhängige Audits, Datenzugang für Forschende und Transparenz bei Werbung.

Für Websitebetreiber ist diese Zahl aus zwei Gründen die belastbarste, die es für Europa gibt. OpenAI hat sie für eine Behörde berechnet und nicht für eine Pressemitteilung, und sie zählt nur Nutzer der Suchfunktion, nicht alle ChatGPT-Nutzer. Jede dieser 159 Millionen Personen hat mindestens einmal im Monat eine Antwort erhalten, die auf live abgerufenen Webseiten beruht.

Woher ChatGPT seine Antworten bezieht

Drei Wege führen Informationen in eine ChatGPT-Antwort, und nur zwei davon lassen sich beeinflussen. Den ersten Weg bilden die Trainingsdaten, die OpenAI bis zu einem Stichtag gesammelt hat und die sich erst mit dem nächsten Modell ändern. Der zweite Weg ist die Websuche, für die OpenAI einen eigenen Crawler und einen eigenen Index betreibt. Beim dritten Weg ruft ChatGPT eine einzelne Seite ab, weil ein Nutzer es auslöst, etwa durch das Einfügen einer Adresse. Fast alles, was als Optimierung für ChatGPT verkauft wird, wirkt auf den zweiten Weg. Und ob dieser Weg bei einer Frage überhaupt beschritten wird, entscheidet das Modell selbst.

Wann ChatGPT eine Websuche startet und wann nicht

Bei 57,8 Prozent der Anfragen an ChatGPT fand in einer Messreihe von Januar bis März 2026 keine Websuche statt, die Antwort enthielt keine einzige Quelle. Julius Schulte hat das in einer Studie zur Stabilität von KI-Sichtbarkeit über 45 Tage und vier Antwortsysteme gemessen, veröffentlicht auf arXiv. Das Modell greift nur dann auf das Web zu, wenn es sein Trainingswissen als unzureichend oder veraltet einschätzt. Fragen mit Zeitbezug, nach Preisen, Verfügbarkeiten, konkreten Anbietern oder Orten lösen eine Suche aus, Definitionen und Zusammenhänge beantwortet das Modell meist aus dem Gedächtnis.

OpenAI legt die Kriterien für den Suchstart nicht offen, die Muster stammen aus Beobachtung. Nutzer können die Suche jederzeit erzwingen, was einen Teil der Anfragen erklärt, bei denen trotz allgemeiner Frage Quellen erscheinen. Daraus folgt, dass die Art der Frage über die Chance auf eine Zitierung entscheidet, lange bevor der Inhalt der Seite eine Rolle spielt.

Was für ChatGPT belegt ist und was Marketing

Die Beleglage einzelner Maßnahmen im ChatGPT SEO ist dünner, als die Zahl der Angebote vermuten lässt. Zu einem klaren Urteil über die bekannteste Zahl der Branche, 40 Prozent mehr Sichtbarkeit aus der Gründungsarbeit zur Generative Engine Optimization, kommt eine kritische Übersicht von 45 Studien aus den Jahren 2023 bis 2026, veröffentlicht im Juli 2026 auf arXiv. Diese Zahl gilt nur innerhalb des damaligen Versuchsaufbaus, in dem die Quelle dem Modell bereits vorlag. Sie sagen nichts darüber aus, ob eine Seite gefunden wird oder ob daraus Besuche entstehen.

Robust ist dagegen der Zusammenhang zwischen organischer Sichtbarkeit und Zitierungen aus der SISTRIX-Studie. Ebenso belastbar ist, dass Google in seiner Anleitung zur Optimierung für generative Suchfunktionen vom Mai 2026 keine neuen Dateien, kein Sondermarkup und keine eigens für Maschinen geschriebenen Texte verlangt. Für ChatGPT existiert keine vergleichbare Anleitung, dort ersetzen Messreihen die Herstellerangabe.

Tabelle 2: Beleglage gängiger Maßnahmen für die Sichtbarkeit in ChatGPT, Stand September 2026

Maßnahme Beleglage Quelle
OAI-SearchBot zulassen Belegt, Herstellerangabe OpenAI-Dokumentation
Organische Sichtbarkeit ausbauen Belegt, Korrelation 0,66 SISTRIX und LEAP, 2026
Erwähnungen in Fachmedien Belegt, 84 Prozent der Zitate aus Earned Media Muck Rack, Mai 2026
Eigenständige, faktenreiche Absätze Plausibel, in Versuchsaufbauten wirksam, im Feld schwach belegt arXiv-Übersicht, Juli 2026
Strukturierte Daten Kleine positive Korrelation, kein Pflichtsignal Google-Anleitung, Mai 2026
llms.txt Unbelegt, kein Anbieter bestätigt die Auswertung Keine Herstellerangabe
Backlinks kaufen Unbelegt, laut Google wirkungslos Google-Anleitung, Mai 2026

Technische Voraussetzungen: So erreicht ChatGPT Ihre Inhalte

Drei Prüfstellen für den Zugriff von OAI-SearchBot: robots.txt, Firewall, Logs

Bevor eine Seite zitiert werden kann, muss OAI-SearchBot sie abrufen und lesen können. An dieser Stelle scheitern mehr Websites, als ihre Betreiber ahnen, weil die Sperre für Besucher unsichtbar bleibt und in keinem Ranking-Report auftaucht. Zwei Prüfungen decken die meisten Fälle auf: der Zugriff des Crawlers und die Frage, ob der Inhalt ohne JavaScript im Quelltext steht. Zusammen dauern beide keine halbe Stunde und brauchen keinen Entwickler. Alles Weitere, etwa Ladezeit, Weiterleitungen und Statuscodes, fällt unter Technisches SEO und gilt für ChatGPT unverändert.

Crawler-Zugriff in robots.txt, Firewall und CDN prüfen und freigeben

Die robots.txt ist nur die erste von drei Stellen, an denen ein Crawler scheitern kann. Öffnen Sie die Datei unter Ihrer Domain mit dem Zusatz /robots.txt und suchen Sie nach den Zeichenketten OAI-SearchBot, GPTBot und nach einer Regel mit User-agent: * gefolgt von Disallow: /. Fehlt ein eigener Eintrag für OAI-SearchBot, gilt die allgemeine Regel, und eine pauschale Sperre trifft auch ihn. Zwei Zeilen genügen für die Freigabe: User-agent: OAI-SearchBot und darunter Allow: /. Laut OpenAI dauert es rund 24 Stunden, bis die Suche eine geänderte robots.txt berücksichtigt.

An zweiter Stelle steht die Web Application Firewall oder der Bot-Schutz des Hosters beziehungsweise des CDN. Cloudflare sortiert KI-Crawler seit Juli 2026 in die Kategorien Search, Agent und Training. Bei neu angebundenen Domains und im kostenlosen Tarif sind Training und Agent seit dem 15. September 2026 auf Seiten mit Werbung standardmäßig gesperrt, Search bleibt erlaubt. Der nutzerausgelöste Abruf per ChatGPT-User ist damit ab Werk gesperrt, bei OAI-SearchBot kommt es auf die Einordnung an. Prüfen Sie im Cloudflare-Dashboard unter Security und AI Crawl Control, welche Kategorie jeder OpenAI-Agent hat und ob er durchkommt, und legen Sie bei Bedarf eine Ausnahme an. Zuletzt bleiben die Serverprotokolle. Suchen Sie in den Logs der letzten vier Wochen nach OAI-SearchBot und prüfen Sie den Statuscode: 200 bedeutet Zugriff, 403 eine aktive Sperre, und ein völliges Fehlen des Agents deutet auf eine Sperre vor dem Server, etwa im CDN. Mit den IP-Bereichen aus der JSON-Datei von OpenAI lassen sich echte Abrufe von gefälschten unterscheiden.

Vergleich von serverseitig gerendertem und per JavaScript nachgeladenem Quelltext

Inhalte serverseitig ausliefern statt per JavaScript nachladen

OAI-SearchBot führt nach allen veröffentlichten Messungen kein JavaScript aus, im Unterschied zum Googlebot, und OpenAI dokumentiert für keinen seiner Crawler eine Rendering-Fähigkeit. Inhalte, die erst im Browser aus einer Schnittstelle nachgeladen werden, existieren für den Crawler nicht. Betroffen sind vor allem Websites auf React, Vue oder Angular ohne serverseitiges Rendering, aber auch klassische Seiten, bei denen Tabs, Akkordeons oder Produktlisten per Skript befüllt werden. Google kommt damit zurecht, ChatGPT nicht.

Geprüft ist das in einer Minute im Browser. Rufen Sie eine Unterseite im Browser auf, öffnen Sie mit der Tastenkombination Strg und U den Quelltext und suchen Sie nach einem Satz aus dem Haupttext. Steht der Satz nicht im Quelltext, obwohl er auf der Seite sichtbar ist, wird er per JavaScript geladen. Dieselbe Prüfung liefert der Befehl curl in der Kommandozeile oder der Abruf-Test in der Google Search Console, wenn Sie dort das gecrawlte HTML statt des gerenderten Screenshots ansehen. Serverseitiges Rendering oder statische Auslieferung lösen das Problem, bei WordPress und den meisten Shopsystemen sind sie der Normalfall und gehen erst durch Erweiterungen verloren.

Vergleich von serverseitig gerendertem und per JavaScript nachgeladenem Quelltext

Inhalte, die ChatGPT übernimmt

Kernaussage an den Anfang, Zahlen mit Datum, keine Pronomen, die auf den Absatz davor zeigen: Diese Grundregeln für zitierfähige Inhalte gelten für alle Antwortsysteme. Für SEO Texte, die zugleich ranken und zitiert werden sollen, kommt nichts hinzu, was für ChatGPT allein gälte. Zwei Besonderheiten ergeben sich trotzdem aus dem, was ChatGPT anders macht als die übrigen Systeme. Zum einen betrifft das die Art der Fragen, bei denen ChatGPT überhaupt sucht, zum anderen die kommerziellen Fragen, die ChatGPT mit wenigen, dafür gewichtigen Quellen beantwortet. Bei beiden lohnt sich eigener Aufwand, weil dort die Konkurrenz um Zitate klein ist.

Vergleichs- und Empfehlungsfragen bedienen

Kommerzielle Fragen an ChatGPT lauten fast nie nach einem Produktnamen, sondern nach dem besten Anbieter für einen Zweck: welche Software für ein Handwerksunternehmen, welcher Steuerberater für Freiberufler in einer Stadt, welches Regalsystem für eine Werkstatt. ChatGPT antwortet mit einer kurzen Liste aus drei bis fünf Namen und je einem Satz Begründung. In diese Liste kommt nur ein Anbieter, dessen Website genau diese Vergleichsfrage beantwortet, mit klaren Kriterien, offen benannten Einschränkungen und dem eigenen Angebot als einer von mehreren Optionen. Reine Leistungsseiten, die nur das eigene Angebot beschreiben, liefern dem Modell keinen Vergleich und werden für Vergleichsfragen selten herangezogen.

Der Aufbau folgt der Frage. Beginnen Sie mit den Kriterien, nach denen die Zielgruppe entscheidet, ordnen Sie das eigene Angebot und mindestens zwei Alternativen daran ein und nennen Sie, für wen welche Lösung passt. Mit einer Tabelle, die die Kriterien in den Zeilen führt, findet das Modell die Angaben leichter. Am schwersten fällt der ehrliche Teil, denn ohne die Nennung von Alternativen wirkt die Seite auf das Modell wie Werbung und wird entsprechend selten übernommen. Welche Vergleiche die Zielgruppe stellt, verrät die Suchintention hinter den bestehenden Suchanfragen, ergänzt um die Fragen, die der Vertrieb im Erstgespräch hört.

Antworten auf Fragen liefern, die eine Websuche auslösen

Wenn ChatGPT bei sechs von zehn Fragen gar nicht sucht, entscheidet die Art der Frage darüber, ob eine Seite zitiert werden kann. Erklärt eine Seite nur, was eine 301 Weiterleitung ist, ruft ChatGPT sie selten ab. Nennt sie dagegen, was eine Umstellung bei einem bestimmten Hoster kostet und wie lange sie im September 2026 dauert, steigt die Chance auf einen Abruf.

Ergänzen Sie bestehende Ratgeber um die Angaben, die das Modell nicht wissen kann: Preise mit Stichtag, Lieferzeiten, Öffnungszeiten, Ansprechpartner, Einzugsgebiet, Gründungsjahr, Zertifikate, Versionsnummern. Auf einer Grounding Page findet das Modell diese Fakten gebündelt an einer Stelle. Datieren Sie jede dieser Angaben sichtbar, weil das Datum dem Modell signalisiert, dass die Seite jünger ist als sein Trainingsstand. Dieselbe Angabe ohne Datum konkurriert mit dem, was das Modell ohnehin zu wissen glaubt.

Mit ChatGPT die eigene SEO-Arbeit beschleunigen

ChatGPT spart als Werkzeug dort Zeit, wo die Aufgabe klar umrissen ist und das Ergebnis sich prüfen lässt: Gliederungen, Varianten für Titles und Descriptions, Fragen für einen FAQ-Bereich, das Sortieren von Begriffslisten. Wo das Ergebnis Zahlen oder Fakten enthält, die das Modell nicht kennen kann, wird die Zeitersparnis zum Risiko. Den Unterschied zwischen beiden Fällen macht der Prüfschritt. Prompts ohne festgelegte Prüfung erzeugen Arbeit, die später jemand ungeprüft veröffentlicht. Aus diesem Grund tragen die folgenden Vorlagen den Prüfschritt gleich mit. Am größten ist der Nutzen bei technischen Aufgaben, die die meisten Anleitungen auslassen, weil dort Syntaxfehler sofort auffallen.

Ablauf Prompt, Ergebnis und Prüfschritt als drei Karten
Vier Kacheln für JSON-LD, robots.txt, Redirect-Map und Search-Console-Export

Technische Aufgaben: JSON-LD, robots.txt-Regeln, Redirect-Maps, Search-Console-Exporte

Fehlerfrei schreibt ChatGPT strukturierte Daten, wenn der Prompt den Typ, die Pflichtfelder und die Werte vorgibt. FAQPage-Markup mit sechs Fragen entsteht in Sekunden, die Prüfung übernimmt der Test für Rich-Suchergebnisse von Google. Ebenso zuverlässig formuliert das Modell robots.txt-Regeln, wenn Sie den Zweck nennen, etwa das Sperren eines Staging-Verzeichnisses für alle Crawler bei freiem Zugang zum Rest. Das Ergebnis kontrolliert der robots.txt-Bericht der Search Console.

Bei einem Relaunch spart die Zuordnung alter zu neuen Adressen die meiste Zeit. Geben Sie beide URL-Listen als Tabelle ein und lassen Sie das Modell die wahrscheinlichste Entsprechung vorschlagen, jede 301 Weiterleitung prüft anschließend ein Crawl mit dem Statuscode-Report. Exporte aus der Search Console mit tausenden Zeilen wertet ChatGPT aus, wenn Sie die CSV-Datei anhängen und die Frage präzise stellen: Welche Seiten haben Impressionen ohne Klicks, welche Suchanfragen enthalten ein bestimmtes Wort. Reguläre Ausdrücke für Filter in der Search Console liefert das Modell ebenfalls, getestet werden sie vor dem Einsatz an drei Beispielen.

Wo ChatGPT scheitert: Suchvolumen, Fakten, Quellen

ChatGPT kennt kein Suchvolumen, auch wenn es auf Nachfrage Zahlen nennt. Diese Zahlen sind geraten, weil das Modell keinen Zugriff auf die Daten von Google oder eines Keyword-Tools hat. Dasselbe gilt für Rankings, Klickraten und Wettbewerbswerte. Beginnt die Keyword Recherche mit dem Modell, liefert es brauchbare Begriffslisten und Cluster, die Bewertung kommt aus dem Tool.

Bei Fakten gilt die Regel, dass jede Zahl, jedes Datum und jedes Zitat aus dem Modell vor der Verwendung gegen die Primärquelle geprüft wird, und wenn keine Quelle auffindbar ist, fällt die Aussage weg. Quellenangaben, die das Modell nennt, sind besonders trügerisch, weil sie plausibel klingen und regelmäßig nicht existieren. Mit eingeschalteter Websuche sinkt die Fehlerquote, verschwindet aber nicht. Texte aus dem Modell tragen ein zweites Risiko, das mit Fakten nichts zu tun hat: Sie ähneln sich über Websites hinweg, weil das Modell dieselben Formulierungen an alle liefert. Derselbe Prompt für zwanzig Kategorietexte produziert Duplicate Content mit anderen Worten.

Drei Karten zu Suchvolumen, Fakten und Quellen mit Problem und Gegenmaßnahme

Sichtbarkeit in ChatGPT messen

Links, die ChatGPT in Antworten setzt, tragen den Parameter utm_source=chatgpt.com. In Google Analytics 4 erscheint dieser Traffic unter der Sitzungsquelle chatgpt.com, in den Serverprotokollen lässt er sich mit derselben Zeichenkette herausfiltern. Traffic aus ChatGPT lässt sich so ohne eigene Vorkehrungen zuordnen. Perplexity und Gemini hängen keinen Parameter an und tauchen je nach Browser als Referral oder als Direktzugriff auf. Ohne eine eigene Kanalgruppe für KI-Quellen gehen die Zahlen im Referral-Sammelposten unter.

Schwerer ist die zweite Messung, die Nennung in Antworten, weil dieselbe Frage an zwei Tagen verschiedene Quellen liefert. In der Messreihe von Schulte überschnitten sich die zitierten Quellen von Tag zu Tag nur zu 34 bis 42 Prozent, die genannten Marken zu 45 bis 59 Prozent. Damit ist die Marke die stabilere Messgröße und die einzelne URL das Rauschen. Gemessen wird darum derselbe Fragenkatalog mehrfach pro Woche über mehrere Wochen, gezählt werden Markennennungen, nicht Links.

Der neue Bericht in der Google Search Console, seit dem 31. August 2026 weltweit für alle Websites verfügbar, zeigt Impressionen in AI Overviews und im AI Mode nach Seiten, Ländern und Geräten, ohne Klicks. Zu ChatGPT sagt er nichts, weil er nur die generativen Funktionen von Google abbildet. Erst die Kombination aus Search-Console-Bericht, Analytics-Segment und wiederholter Abfrage des eigenen Fragenkatalogs zeigt beide Systeme zusammen. Nur eine SEO Analyse, die diesen Ausgangswert vor der ersten Maßnahme festhält, erlaubt später den Nachweis eines Fortschritts.

Balken zur Überschneidung zitierter Quellen und Marken von Tag zu Tag

Warum eine Website trotz guter Rankings nicht in ChatGPT erscheint

Gute Rankings erhöhen die Wahrscheinlichkeit einer Zitierung, garantieren sie aber nicht. Die Korrelation von 0,66 lässt Raum für Websites, die bei Google vorn stehen und in ChatGPT trotzdem fehlen. In den meisten dieser Fälle liegt eine von vier Ursachen vor, und jede lässt sich mit einem eigenen Prüfschritt eingrenzen. Ihre Reihenfolge richtet sich nach dem Prüfaufwand, von der schnellsten zur aufwendigsten Prüfung. Erst wenn die ersten drei ausgeschlossen sind, lohnt der Blick auf den Absatz selbst.

Icon Websuche

Die Frage löst keine Websuche aus

Ohne Websuche kann keine Website zitiert werden, so gut sie auch rankt. Prüfen Sie, ob Ihre Testfragen überhaupt eine Suche auslösen: Erscheinen unter der Antwort Quellenangaben oder der Hinweis auf durchsuchte Websites, hat eine Suche stattgefunden. Fehlt beides, hat das Modell aus dem Gedächtnis geantwortet. Formulieren Sie die Frage dann so, wie ein Interessent sie stellen würde, mit Ort, Zeitraum oder Preisbezug, und wiederholen Sie den Test. Bleibt die Suche aus, gehört das Thema zu denen, bei denen ChatGPT sein Trainingswissen für ausreichend hält, und die Optimierung lohnt sich für diese Frage nicht.

Icon Bing-Index

Die Seite fehlt im Bing-Index

Seiten, die Google indexiert hat, stehen nicht automatisch auch im Index von Bing. Kleinere Websites crawlt Bing seltener, und ohne Anmeldung in den Webmaster Tools kann die Indexierung Monate dauern. In den Bing Webmaster Tools zeigt die URL-Prüfung, ob die betroffene Seite im Index ist, und nennt den Grund, falls nicht: gesperrt, Fehlerseite oder schlicht noch nicht gecrawlt. Ist die Seite nicht enthalten, reichen Sie die URL dort direkt zur Indexierung ein. Wie Sie eine Website bei Suchmaschinen anmelden, unterscheidet sich zwischen Google und Bing nur in Details, der Aufwand liegt bei einer Stunde.

Icon Trainingsdaten

ChatGPT antwortet aus den Trainingsdaten statt aus dem Web

Auch wenn eine Suche stattfindet, kann das Modell Angaben über ein Unternehmen aus dem Trainingsstand übernehmen und mit den gefundenen Quellen mischen. Erkennbar ist das an Angaben, die auf keiner zitierten Seite stehen: ein alter Preis, ein früherer Standort, eine eingestellte Leistung. Fragen Sie ChatGPT direkt nach Ihrem Unternehmen und vergleichen Sie jede Angabe mit den Quellen unter der Antwort. Stimmt eine Angabe mit keiner Quelle überein, stammt sie aus dem Training. Korrigieren lässt sie sich nur, indem die richtige Angabe mit Datum an vielen Stellen im Netz gleichlautend steht, bis das Modell die Live-Quellen höher gewichtet als sein Gedächtnis.

Icon extrahierbare Antwort

Der Absatz enthält keine extrahierbare Antwort

Aus einer gefundenen Seite übernimmt ChatGPT nur die Passage, die für sich allein verständlich ist. Absätze, die mit einem Pronomen beginnen oder die Antwort auf drei Absätze verteilen, werden gefunden, aber nicht zitiert. Lesen Sie jeden Absatz einzeln und fragen Sie, ob er ohne den Rest der Seite eine Frage beantwortet. Für die Prüfung eignet sich ChatGPT selbst: Fügen Sie den Absatz ein und fragen Sie, welche Frage er beantwortet. Kommt keine oder eine falsche Antwort, weiß das Modell im Ernstfall auch nicht, wofür es die Passage zitieren soll.

Häufige Fragen zu ChatGPT SEO

Nein. GPTBot sammelt Inhalte für das Training künftiger Modelle, über die Sichtbarkeit in der ChatGPT-Suche entscheidet OAI-SearchBot. Gesperrter GPTBot kostet keine Sichtbarkeit in Suchantworten, gesperrter OAI-SearchBot dagegen schon. Viele Websites haben 2023 und 2024 GPTBot gesperrt und den später eingeführten OAI-SearchBot nie freigegeben, ein Blick in die robots.txt lohnt sich darum bei jeder Website, die älter als zwei Jahre ist.

Ja, OpenAI dokumentiert Anzeigen in ChatGPT samt einem eigenen User-Agent OAI-AdsBot, der die Zielseiten von Anzeigen prüft. Anzeigen erscheinen als gekennzeichnete Einblendungen, die Quellen in der Antwort bleiben davon unberührt. Das Verhältnis entspricht dem von SEO vs SEA bei Google: Anzeigen kaufen Reichweite für die Dauer des Budgets, Zitierungen entstehen aus Inhalten und Erwähnungen und bleiben bestehen.

Nicht als eigener Kanal. Google Analytics 4 ordnet Sitzungen mit der Quelle chatgpt.com dem Standardkanal Referral zu, und ohne Referrer landen sie unter Unassigned, obwohl der Parameter utm_source gesetzt ist, weil utm_medium fehlt. Sichtbar wird der Anteil erst über eine eigene Kanalgruppe mit den Quellen chatgpt.com, perplexity.ai, gemini.google.com und claude.ai. Besuche aus den ChatGPT-Apps tragen denselben Parameter und zählen mit.

In den Grundlagen ja, in den Details nein. Erreichbare Technik, faktenreiche Absätze und Erwähnungen auf Drittseiten wirken in allen Systemen. Perplexity und Gemini suchen bei fast jeder Frage und zitieren breiter, ChatGPT sucht seltener und stützt sich auf wenige Quellen. Jedes System betreibt eigene Crawler mit eigenem Namen, und bestehende Sperren in der robots.txt treffen sie jeweils einzeln.

Ja, unter zwei Bedingungen. Die Website liefert Fakten, die sonst niemand hat, etwa Preise für eine Region, Erfahrungswerte aus einer Nische oder Vergleiche, die große Anbieter aus Eigeninteresse nicht veröffentlichen. Und die Frage, für die sie zitiert werden will, löst eine Websuche aus. Bei allgemeinen Fragen entscheidet die Bekanntheit der Domain, bei spezifischen Fragen die Passung der Passage.

Philipp Nessmann, SEO-Berater bei SEO Agents
Philipp Nessmann
  • LinkedIn-Profil von Philipp Nessmann
  • YouTube-Kanal von Philipp Nessmann

Experte für SEO, GEO, LLMO & AIO – wir machen Sie sichtbar bei Google, ChatGPT & Perplexity.

Philipp Nessmann ist SEO-Berater mit über 20 Jahren Erfahrung und Gründer der Nessmann GmbH (Marken: Contentbär und SEO Agents). Er hat mehr als 1.100 Projekte betreut und mit Jurawelt.com sowie trauringspezialisten.de eigene Plattformen aufgebaut. Sein Schwerpunkt liegt auf technischem SEO und der Sichtbarkeit in KI-Systemen wie ChatGPT, Gemini und Perplexity (GEO). Als Gastautor veröffentlicht er regelmäßig u. a. bei Ahrefs, OMR, GoDaddy, HostEurope, Mittwald und DomainFactory.

Nutzen Sie unsere kostenfreie IST-Analyse Ihres Webprojekts