Keyworddichte: Definition, Berechnung und warum sie kaum noch über Rankings entscheidet

In Kürze
Keyworddichte auf einen Blick
  • Kein Zielwert: Google hat nie einen optimalen Prozentwert veröffentlicht, die Kennzahl taugt als Kontrolle nach oben, nicht als Optimierungsziel.
  • Zählweise entscheidet: Ob nur der Fließtext oder auch Überschriften und Alt-Texte gezählt werden, verändert das Ergebnis, zwei Tools melden für denselben Text verschiedene Werte.
  • Mehrwortbegriffe verzerren: Bei Long-Tail-Keywords zählt eine strenge Messung nur die exakte Wortfolge und meldet zu niedrige Werte, obwohl das Thema den Text durchzieht.
  • Wiederholung ist Spam: Sinnloses Wiederholen eines Begriffs in immer gleichen Mustern verstößt gegen die Spam-Richtlinien von Google, eine Prozentgrenze dafür gibt es nicht.
Stand: 27. September 2026

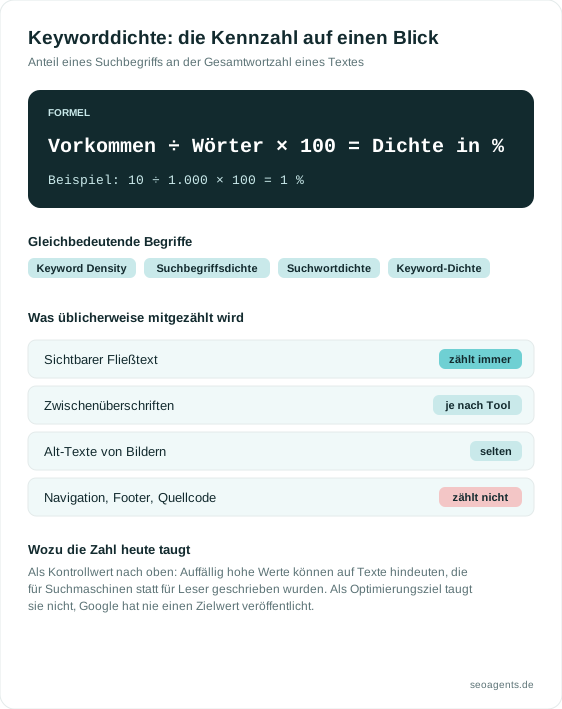
Unter der Keyworddichte versteht die Suchmaschinenoptimierung den prozentualen Anteil eines Suchbegriffs an der Gesamtwortzahl eines Textes. Berechnet wird sie, indem die Anzahl der Vorkommen durch die Wortzahl geteilt und mit 100 multipliziert wird. Feste Zielwerte gibt es nicht, weil Google Inhalte unter anderem nach Themenabdeckung und Suchintention bewertet und reine Wiederholung dabei keinen Vorteil bringt.
Was ist die Keyworddichte?

Diese Kennzahl beschreibt, wie stark ein einzelner Suchbegriff einen Text dominiert, ausgedrückt in Prozent der Gesamtwortzahl. Kommt ein Begriff zehnmal in einem Text mit 1.000 Wörtern vor, liegt seine Dichte bei einem Prozent. Im Englischen heißt sie Keyword Density, im Deutschen kursieren daneben Suchbegriffsdichte, Suchwortdichte und die Schreibweise Keyword-Dichte mit Bindestrich. Gemeint ist in allen Fällen dasselbe Verhältnis.

Entstanden ist die Kennzahl in den Anfangsjahren der Suchmaschinen, als Google die Häufigkeit eines Wortes noch als starkes Signal für das Thema einer Seite las. Ältere Empfehlungen aus dieser Zeit nannten teils Werte von mehreren Prozent, neuere Ratgeber liegen meist deutlich darunter. Je genauer Suchmaschinen Inhalte verstehen, desto weniger sagt reine Wiederholung über ein Thema aus.

Heute dient die Dichte vor allem als Kontrollwert nach oben. Auffällig hohe Werte können auf Texte hindeuten, die für Suchmaschinen statt für Leser geschrieben wurden. Welcher Begriff überhaupt gezählt wird, klärt vorher die Keyword Recherche
, denn eine perfekte Dichte für das falsche Wort bringt niemanden weiter.

Keyworddichte auf einen Blick: Formel, Synonyme und was mitgezählt wird

Wie berechnen Sie die Keyworddichte?

Sie teilen die Anzahl der Vorkommen des Suchbegriffs durch die Gesamtwortzahl und multiplizieren das Ergebnis mit 100. Jedes Textprogramm liefert beide Zahlen über die Suchfunktion. Gezählt wird üblicherweise nur der sichtbare Fließtext, also ohne Navigation, Footer und Quellcode. Umgekehrt lässt sich aus der Formel ableiten, wie oft ein Begriff bei einer gewünschten Dichte höchstens vorkommen darf. Bei 1.500 Wörtern und einer Obergrenze von einem Prozent wären das 15 Nennungen. Das Zählen ist aufwendiger als die Rechnung, weil jedes Werkzeug anders zählt. Beim Selberrechnen wissen Sie zumindest, was mitgezählt wurde.

Rechenbeispiel Keyworddichte: Seitenskizze mit zwei Zählweisen, 0,75 und 0,9 Prozent

Rechenbeispiel an einem Textausschnitt

Angenommen, ein Ratgeber zum Thema Wärmepumpe umfasst 1.200 Wörter. Der Begriff Wärmepumpe steht im Text neunmal, dazu kommen zwei Nennungen in Zwischenüberschriften. Zählt nur der Fließtext, ergibt sich eine Dichte von 0,75 Prozent, mit den Überschriften sind es rund 0,9 Prozent. Beide Werte liegen in einem Bereich, den niemand als auffällig einstufen würde. Dieser Unterschied zwischen den Zählweisen zeigt aber, weshalb zwei Tools für denselben Text verschiedene Ergebnisse melden.


Was bei mehrteiligen Keywords als Vorkommen zählt

Das Problem der Formel beginnt bei Long Tail Keywords, die aus drei oder mehr Wörtern bestehen. Lautet der Suchbegriff Wärmepumpe Kosten Einfamilienhaus, bleibt offen, ob nur die exakte Wortfolge zählt oder auch die Formulierung Kosten einer Wärmepumpe im Einfamilienhaus. Beide Varianten meinen dasselbe, nur die zweite liest sich wie normales Deutsch. Strenge Tools zählen ausschließlich die exakte Phrase und melden dann eine zu niedrige Dichte, obwohl das Thema den ganzen Text durchzieht. Lockere Zählweisen erfassen jedes Einzelwort und kommen auf Werte, die mit dem Suchbegriff wenig zu tun haben. Der Rechner in diesem Beitrag zeigt deshalb beide Werte nebeneinander, damit der Unterschied sichtbar bleibt.

Rechenbeispiel Keyworddichte: Seitenskizze mit zwei Zählweisen, 0,75 und 0,9 Prozent

Gibt es eine optimale Keyworddichte?

Nein, einen belegten optimalen Wert gibt es nicht, weder von Google noch aus unabhängigen Messungen. In der SEO-Branche kursieren Empfehlungen zwischen 0,5 und 5 Prozent, je nach Quelle mit unterschiedlicher Sicherheit vorgetragen. Manche Ratgeber staffeln nach Textart und nennen für Blogbeiträge andere Werte als für Produkttexte, andere geben eine einzige Spanne für alles an. Hinter der Spanne stehen Erfahrungswerte einzelner Anbieter, keine gemeinsame Messung.

Warum die Werte so weit auseinandergehen, hat vier Gründe. Textlänge verschiebt jede Prozentzahl, weil zehn Nennungen in 500 Wörtern etwas anderes bedeuten als in 3.000. Content-Typ zählt ebenfalls, denn eine Kategorieseite mit vielen Produktvarianten wiederholt den Produktnamen naturgemäß öfter als ein Ratgeber. Dazu kommen die Tools selbst, die Überschriften, Meta-Angaben und mehrteilige Begriffe unterschiedlich behandeln. Und zuletzt verschiebt sich die Referenz ständig, weil neue Seiten mit anderen Werten in die Top-Rankings aufsteigen.

Empfehlungen zur Keyworddichte zwischen 0,5 und 5 Prozent im Vergleich

Keyword-Stuffing: Wenn Wiederholung zum Risiko wird

Keyword-Stuffing bezeichnet das absichtliche Vollstopfen eines Textes mit Suchbegriffen, um Suchmaschinen Relevanz vorzutäuschen. Die Methode stammt aus der Zeit, in der die Dichte noch als Rankingsignal galt, und taugt heute nicht mehr als Rankingstrategie. Google führt sie in den Spam-Richtlinien ausdrücklich als Verstoß auf. Ähnliche Warnungen vor Aufzählungen von Suchbegriffen gibt Google für Meta-Descriptions und Alt-Texte. Versteckte Textblöcke am Seitenende gelten in den Richtlinien als eigener Verstoß. In der Praxis begegnet einem das Muster heute seltener in neuen Texten als in alten Bestandsseiten, die seit Jahren niemand überarbeitet hat. Genau dort lohnt der Blick auf die Dichte noch am ehesten, etwa im Rahmen einer SEO Analyse des Bestands.

Keyword-Stuffing erkennen: überoptimierter Absatz gegen Leserfassung mit Merkmalen

Ist WDF*IDF die bessere Keyworddichte?

WDF*IDF ersetzt die Prozentzahl durch einen Vergleich mit gut platzierten Wettbewerbern, ist aber ebenfalls kein von Google veröffentlichter Rankingmechanismus, sondern eine Analysemethode der SEO-Branche. Die Abkürzung steht für Within Document Frequency mal Inverse Document Frequency. Das verwandte Konzept TF-IDF stammt aus der Informationswissenschaft und steuert seit Jahrzehnten Bibliotheks- und Suchsysteme.

Statt eine Prozentzahl zu liefern, gewichtet die Formel jeden Begriff nach zwei Kriterien. Gezählt wird, wie häufig er im eigenen Dokument steht und wie selten er über viele andere Dokumente hinweg vorkommt. Seltene Fachbegriffe erhalten dadurch mehr Gewicht als Allerweltswörter. Für die Texterstellung bedeutete das einen Fortschritt, weil der Blick von einem einzelnen Wort auf ein ganzes Begriffsfeld wanderte.

Was WDF*IDF misst und wo die Grenzen liegen

Im Kern funktioniert eine WDF*IDF-Analyse wie eine SEO Konkurrenzanalyse auf Wortebene. Die Tools nehmen die Texte der Top-Rankings zu einem Suchbegriff und ermitteln die dort verwendeten Begriffe samt Gewichtung. Anschließend zeigen sie an, welche Wörter im eigenen Text fehlen oder zu selten vorkommen. Das hilft beim Aufdecken vergessener Teilthemen.

Was die Formel nicht sieht, sind Bedeutung und Absicht. Sie zählt Vorkommen und erkennt Synonyme dabei nicht als verwandt. Struktur und Suchintention bleiben außen vor. Baut jemand die vorgeschlagenen Begriffe mechanisch ein, entsteht am Ende wieder ein Text für Maschinen, nur mit größerem Wortschatz.

Entitäten statt Keyword-Wiederholung

Google arbeitet seit 2012 mit dem Knowledge Graph, einer Datenbank aus Entitäten. Gemeint sind eindeutig identifizierbare Dinge, Personen, Orte und Konzepte samt ihrer Beziehungen zueinander. Vereinfacht gesagt hilft dieses Verständnis beim Einordnen, ob eine Seite von der Frucht oder vom Unternehmen Apple handelt. Die Häufigkeit des Wortes trägt dazu wenig bei. Wie stark dieses semantische Verständnis in die Bewertung einzelner Seiten einfließt, legt Google nicht offen.

Häufig taucht in diesem Zusammenhang der Begriff LSI-Keywords auf, verbunden mit der Behauptung, Google nutze Latent Semantic Indexing zur Bewertung von Inhalten. Dafür gibt es keinen Beleg, John Mueller hat die Existenz von LSI-Keywords 2019 ausdrücklich verneint. Richtig bleibt trotzdem der Rat, der dahintersteht. Verwandte Begriffe, Synonyme und Teilaspekte eines Themas gehören in den Text, weil sie zeigen, dass ein Thema in der Breite behandelt wird. Diese Themenautorität, in der Branche als Topical Authority bezeichnet, lässt sich weder mit einer Prozentzahl messen noch mit Wiederholungen aufbauen.

Welche Tools ermitteln die Keyworddichte?

Jedes Textprogramm mit Suchfunktion, CMS-Plugins wie Yoast SEO oder Rank Math, Online-Checker per URL und der Rechner in diesem Beitrag ermitteln sie. Für die reine Berechnung braucht niemand ein Spezialwerkzeug. Trotzdem lohnt ein Blick auf die Werkzeugklassen, weil jede etwas anderes zählt und etwas anderes verspricht.

Werkzeug Was es zählt Stärke Schwäche
Rechner oben im Beitrag Fließtext, wahlweise exakte Phrase oder Einzelwörter Zeigt beide Zählweisen, Umkehrrechnung, Fundstellen im Text Analysiert nur eingefügten Text, keine URL
Textprogramm (Suchen und Ersetzen) Jede Zeichenfolge, auch Wortbestandteile Überall verfügbar, keine Anmeldung Zählt Wortbestandteile mit, keine Prozentangabe
CMS-Plugins wie Yoast SEO oder Rank Math Fokus-Keyphrase im Beitragstext Live-Prüfung beim Schreiben, Ampelsystem Erkennen Wortformen und umgestellte Phrasen oft nur in Bezahlversionen
Online-Checker per URL Haupttext der Live-Seite, alle Wörter Zeigt auch die Dichte der Konkurrenz Zählweise selten transparent, teils mit Navigation
WDF*IDF-Tools Begriffsgewichtung im Vergleich zu Top-Rankings Deckt fehlende Teilthemen auf Kostenpflichtig, verleitet zum mechanischen Einbau

Die Ampel der Plugins, die bei WordPress die Fokus-Keyphrase prüfen, verdient dabei eine Anmerkung. Bei mehrteiligen Suchbegriffen springt sie in kostenlosen Versionen häufig auf Rot, obwohl der Text das Thema in natürlichen Formulierungen vollständig abdeckt. Rankt der Beitrag gut, ist die rote Ampel kein Grund zum Nachbessern. Alle genannten Klassen eignen sich als Kontrolle nach oben. Keine davon liefert ein Ziel für die Optimierung.

Werkzeugklassen zur Keyworddichte und was sie erfassen

Was zählt statt der Keyworddichte für das Ranking?

Für Google zählt, ob eine Seite die Frage hinter einer Suchanfrage beantwortet. Platzierung, Themenabdeckung und Passung zur Suchintention wiegen dafür schwerer als jede Häufigkeit. Keines dieser Signale lässt sich mit einer einzelnen Prozentzahl abbilden. Trotzdem spielt der Suchbegriff weiter eine Rolle, nur an anderer Stelle als früher. Diese Verschiebung erklärt auch, warum ältere Texte mit hoher Dichte weiter ranken können, solange sie die Frage hinter der Suche beantworten.

Platzierung an den Signalstellen

Einige Positionen im Dokument helfen Google beim Einordnen des Themas stärker als beliebige Stellen im Fließtext. Dazu zählen der Seitentitel, die H1, der Einstieg des Textes, Zwischenüberschriften und die URL, sofern der Begriff dort natürlich hineinpasst. Zur OnPage SEO einer Seite gehört, diese Stellen zu pflegen, ohne den Begriff dort zu erzwingen. Feste Regeln wie eine Mindestzahl an Überschriften mit Keyword hat Google nie veröffentlicht. Steht der Begriff an diesen Stellen, fällt die thematische Zuordnung leichter, und im restlichen Text darf er so oft vorkommen, wie es die Sprache erlaubt.

Auch die interne Verlinkung gehört dazu. Alt-Texte von Bildern ergänzen das Bild, wenn das Motiv zum Thema passt. Der Linktext eingehender Verweise beschreibt Google zusätzlich, worum es auf der Zielseite geht.

Signalstellen für den Suchbegriff auf einer Seite, Meta-Description getrennt

Themenabdeckung und semantische Breite

Suchmaschinen erkennen ein Thema an der Menge zusammengehöriger Begriffe, nicht an der Wiederholung eines einzelnen. Behandelt ein Text über Wärmepumpen auch Jahresarbeitszahl, Vorlauftemperatur, Förderung und Stromverbrauch, wirkt er vollständiger als einer, der nur das Hauptwort wiederholt. Diese Breite entsteht aus den Teilfragen, die Suchende zum Thema stellen. Dabei ordnet ein Keyword Mapping jeder Seite ihr Thema zu und verhindert, dass mehrere Seiten derselben Domain um denselben Begriff konkurrieren. Synonyme fließen dann von selbst in den Text, weil ein Thema in der Breite nun einmal verschiedene Wörter braucht.

Begriffsnetz rund um Wärmepumpe und Keyword Mapping mit einer Seite je Thema

Suchintention, Struktur und Belege

Hinter jeder Suchanfrage steht eine Absicht, und die entscheidet über das Format. Sucht jemand nach Wohnzimmer-Deko-Ideen, erwartet er Bilder und keinen Fließtext von 2.000 Wörtern, ganz gleich, wie gut dessen Begriffe gewichtet sind. Die Suchintention bestimmt also, ob ein Ratgeber, eine Vergleichstabelle, ein Produktlisting oder ein Video die richtige Antwort ist. Verfehlt eine Seite das erwartete Format, hilft keine noch so saubere Begriffsverteilung.

Innerhalb des passenden Formats zählen Aufbau und Belege. Für alle, die SEO Texte schreiben, wiegt der Aufbau mindestens so viel wie die Wortwahl. Kurze Absätze, sprechende Zwischenüberschriften und ein Antwortblock zu Beginn helfen Menschen beim Überfliegen und Maschinen beim Extrahieren.

Bei Themen mit Folgen für Gesundheit, Geld oder Sicherheit, bei Google unter YMYL geführt, legt Google nach den eigenen Qualitätsrichtlinien zusätzlich Wert darauf, wer schreibt. Ebenso zählt, worauf sich die Aussagen stützen. Benannte Autoren mit erkennbarer Qualifikation und Quellenangaben gehören deshalb in jeden SEO Content, der über Rankings hinaus Vertrauen aufbauen soll.

Das gilt für Ratgeber ebenso wie für Leistungsseiten. Wo die eigenen Texte in diesen drei Bereichen stehen, klärt eine SEO Beratung schneller als jedes Dichte-Tool.

Suchanfragen mit erwartetem Format und Bausteine für Aufbau und Belege

Spielt die Keyworddichte in AI Overviews und ChatGPT noch eine Rolle?

Für die KI-Funktionen der Google-Suche gelten laut Google keine zusätzlichen Anforderungen, und die Dichte gehört auch dort nicht zu den genannten Kriterien. In der Dokumentation zu KI-Funktionen heißt es, eine Seite müsse lediglich indexiert und für ein Snippet geeignet sein, um in AI Overviews oder im AI Mode als Quelle zu erscheinen.

Keyworddichte in KI-Antworten: Voraussetzungen laut Google und Bedeutungsraum

Dieselben Grundlagen gelten demnach wie für die klassische Suche. Sprachmodelle verarbeiten Text vereinfacht gesagt als Bedeutungsräume, in denen Wärmepumpe, Heizungswärmepumpe und Luft-Wasser-Anlage nahe beieinander liegen. Neun oder zwölf Nennungen eines Begriffs ändern an dieser Zuordnung kaum etwas. Nach allem, was sich bislang beobachten lässt, zahlen sich klare und belegte Aussagen zu einer konkreten Frage aus, Wiederholungen dagegen nicht. Weil sich die Anzeigeformen der KI-Suche in kurzen Abständen ändern, gehört das Beobachten dieser Signale in die SEO Betreuung und nicht in eine einmalige Optimierung.

Häufige Fragen zur Keyworddichte

Nein, Google hat die Dichte nie als Rankingfaktor bestätigt und einen Zielwert mehrfach verneint. Auffällig hohe Werte können dagegen als Spam gewertet werden.

Das hängt vom Werkzeug ab. Klassische Rechner zählen nur die exakte Zeichenfolge, Wortformen wie Wärmepumpen oder Synonyme bleiben außen vor. Google dagegen erkennt Beugungen und verwandte Begriffe, weshalb eine niedrige gemessene Dichte nichts darüber aussagt, ob die Seite für den Begriff in Frage kommt.

Kopieren Sie den sichtbaren Haupttext der Seite in den Rechner in diesem Beitrag. Alternativ nimmt ein Online-Checker die URL direkt entgegen. Achten Sie darauf, Navigation und Footer nicht mitzuzählen, sonst fällt der Wert zu niedrig aus.

Google nennt keine feste Grenze. Am zuverlässigsten funktioniert der Vorlese-Test: Fällt die Wiederholung beim lauten Lesen störend auf, ist die Grenze überschritten. Entscheidend sind Kontext, Natürlichkeit und die erkennbare Absicht, Suchbegriffe künstlich zu wiederholen.

Nur bei manchen Tools. Die meisten Rechner werten nur den sichtbaren Fließtext aus, einige beziehen Überschriften ein, kaum eines die Alt-Texte. Entscheidend ist für Google nicht eine bestimmte Dichte, sondern unter anderem, ob Thema und Suchintention klar aus dem Inhalt hervorgehen.

Philipp Nessmann, SEO-Berater bei SEO Agents
Philipp Nessmann
  • LinkedIn-Profil von Philipp Nessmann
  • YouTube-Kanal von Philipp Nessmann

Experte für SEO, GEO, LLMO & AIO – wir machen Sie sichtbar bei Google, ChatGPT & Perplexity.

Philipp Nessmann ist SEO-Berater mit über 20 Jahren Erfahrung und Gründer der Nessmann GmbH (Marken: Contentbär und SEO Agents). Er hat mehr als 1.100 Projekte betreut und mit Jurawelt.com sowie trauringspezialisten.de eigene Plattformen aufgebaut. Sein Schwerpunkt liegt auf technischem SEO und der Sichtbarkeit in KI-Systemen wie ChatGPT, Gemini und Perplexity (GEO). Als Gastautor veröffentlicht er regelmäßig u. a. bei Ahrefs, OMR, GoDaddy, HostEurope, Mittwald und DomainFactory.

Nutzen Sie unsere kostenfreie IST-Analyse Ihres Webprojekts